
NVIDIA PAIR : les machines qui dorment sur votre réseau deviennent un cluster d'inférence
En bref
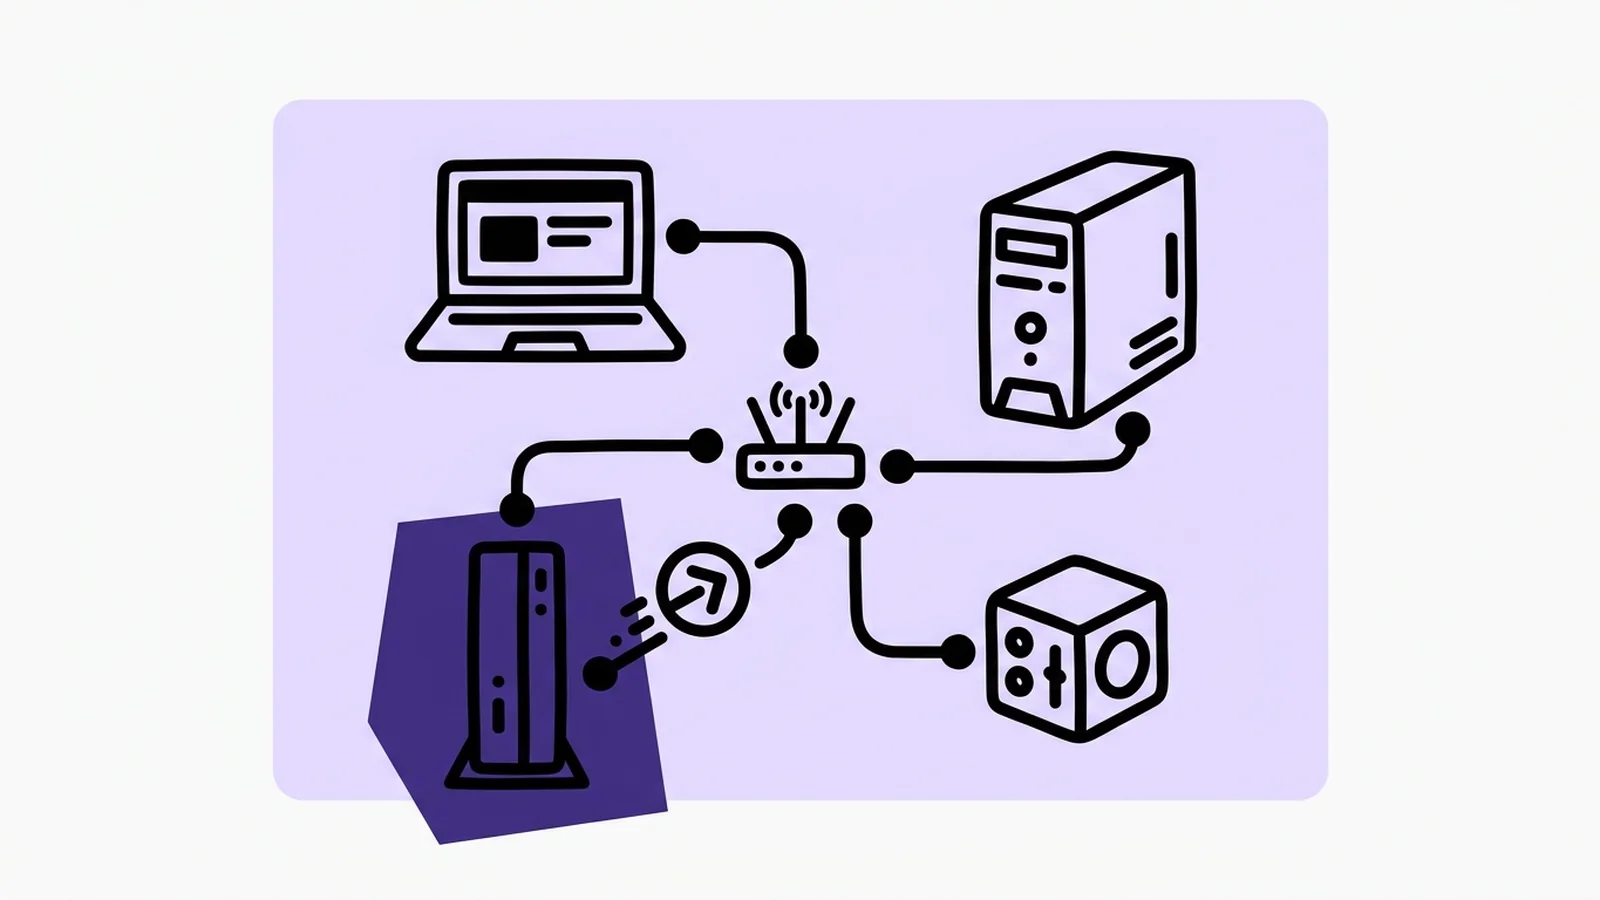
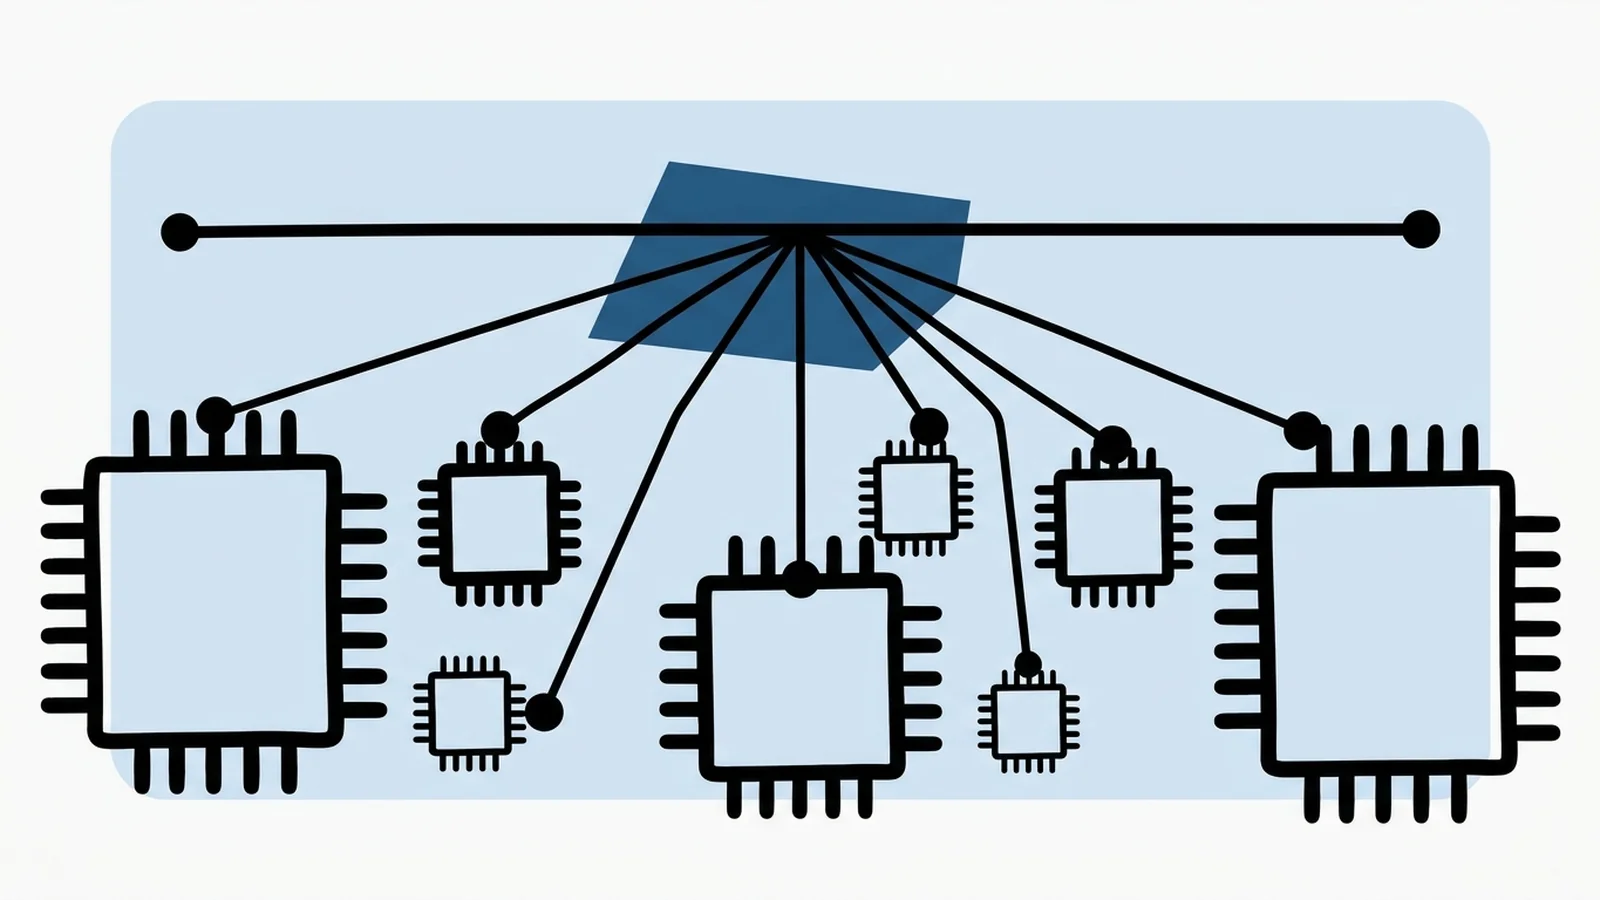
Le 3 septembre 2026, à la veille de l'IFA, NVIDIA a publié en beta publique le Personal AI Router (PAIR), un logiciel open source sous licence Apache 2.0. Installé sur plusieurs machines d'un même réseau, il expose un endpoint Ollama ou OpenAI unique et envoie chaque requête vers une machine qui annonce le modèle dans son inventaire, en tenant compte de sa file d'attente et de la charge de son GPU. Dans la démo de NVIDIA, une tâche menée par cinq sous-agents passe en moyenne de 18 minutes sur un portable à 8 minutes 48 sur trois machines. Chaque requête s'exécute entière sur une seule machine, avec sa propre VRAM : le gain vient des requêtes lancées en parallèle.
Ce que NVIDIA a livré le 3 septembre
Seth Schneider, senior product manager chez NVIDIA, signe le billet d'annonce sur le blog technique. Il présente PAIR comme un virtual inference router : un service qui découvre les machines du réseau local, apprend quel moteur d'inférence tourne sur chacune (Ollama, LM Studio) et quels modèles y sont présents, puis dispatche les requêtes.
Le logiciel s'installe sur Windows 11, Linux et macOS (x64 et arm64, Windows ARM en expérimental). NVIDIA valide en beta les GeForce RTX à partir de la série 20, les RTX PRO à partir de Turing, les DGX Spark (GB10) et les Mac à puce M4 ou plus récente. NVIDIA demande 8 Go de RAM et recommande 20 Go de disque. L'accès à Internet ne sert qu'à télécharger les modèles ; PAIR lui-même fonctionne hors ligne. Une machine sans GPU ni moteur d'inférence peut rejoindre le cluster : c'est même l'usage prévu pour le poste où l'on travaille, qui envoie ses requêtes vers les nœuds équipés. Le code est sur GitHub, dans le dépôt NVIDIA/Personal-AI-Router. La première release, v0.1.0, date du 26 août 2026 ; la v0.1.1, en ligne au lancement de la beta, est publiée le 28 août et se déclare fonctionnellement identique.
Avec le support des Mac M4, NVIDIA route du calcul Apple Silicon avec son propre logiciel. Adam Conway, qui a monté un cluster de deux PC pour XDA Developers, ajoute que des cartes AMD ou Intel servent aussi des requêtes si Ollama ou LM Studio y tournent, même si elles n'apparaissent pas dans la liste officielle.
Cité par TechSpot, Schneider met en avant un foyer dont les machines cumulent 165 téraFLOPS, un gisement qu'il décrit comme « a treasure trove of "free tokens" sitting idle ».
Comment une requête traverse PAIR
Sur chaque machine, PAIR lance des services écrits en Go et une interface Electron. Les nœuds se découvrent en mDNS sur le réseau local, s'apparient avec un code PIN à six chiffres, puis font passer l'essentiel de leur trafic en mTLS. Le cluster est pair-à-pair : aucun nœud maître, et un nœud n'appartient qu'à un seul cluster.
PAIR prend les ports habituels : il écoute sur le 11434 (Ollama) et le 1234 (LM Studio, API compatible OpenAI) et décale le vrai moteur sur 11435 et 1235, ou sur le premier port libre au-dessus. Une application qui parlait déjà à un Ollama local continue de parler à 127.0.0.1:11434 sans modification ; elle s'adresse désormais au routeur. Les ports 14318 à 14323 servent au contrôle du cluster, et le 5353/udp à mDNS.
À la réception d'une requête, PAIR retient les nœuds joignables dont le moteur peut servir la requête et dont l'inventaire annonce le modèle, sous son tag exact pour LM Studio (Ollama normalise le :latest implicite). Un nœud épinglé à la main passe en premier ; sinon, le scheduler classe les candidats selon le travail en file et la charge GPU. Si le nœud choisi répond 404, la requête passe au suivant. Une fois la génération lancée, elle reste sur ce nœud jusqu'à la fin. Chaque machine garde ses propres modèles : il faut copier le tag de modèle sur chaque nœud censé pouvoir le servir. La vue Jobs de l'interface montre ensuite quel nœud a traité quoi.
Ce que PAIR refuse de faire
NVIDIA liste les cas hors périmètre dans sa documentation, et la presse a repris la liste presque mot pour mot. PAIR ne met pas la VRAM en commun : quatre machines dotées de 16 Go de mémoire vidéo restent quatre machines de 16 Go, et aucune ne fera tourner un modèle qui exige 60 Go. Il ne découpe pas un modèle entre plusieurs nœuds (pas de tensor parallelism, comme le rappelle PC Watch), ne fractionne pas une génération en cours et ne migre pas une requête déjà lancée. Il ne remplace pas Ollama ni LM Studio : sans moteur installé et modèle téléchargé, un nœud PAIR ne sert rien. La beta ne repère pas non plus un service PAIR resté lancé qui ne répond plus : NVIDIA le liste dans ses problèmes connus.
Un appel unique et long vers un seul modèle prend donc le même temps avec ou sans PAIR. Le gain n'existe que lorsque plusieurs requêtes indépendantes se disputent le calcul.
Quand le gain apparaît
La démo de NVIDIA porte sur un cas agentique. Hermes Desktop pilote Ollama et le modèle Qwen 3.6 35B A3B, avec cinq sous-agents lancés en parallèle. Sur un seul portable équipé de RTX Spark (la puce Arm annoncée par NVIDIA et Microsoft le 31 mai 2026), la tâche prend 18 minutes en moyenne. Sur un cluster de trois nœuds (le même portable, un DGX Spark et un PC équipé d'une RTX 5090), elle prend 8 minutes 48 en moyenne. NVIDIA qualifie cette démonstration de non officielle et propre à sa configuration, et précise qu'il ne s'agit pas d'un benchmark universel ; le ratio dépend du nombre de sous-agents et de la puissance relative des machines.
CNET, sous la plume de Lori Grunin, retient cet angle : PAIR accélère les agents en annexant les PC du réseau. Les frameworks d'agents locaux comme Hermes ou OpenClaw multiplient les appels parallèles à des modèles ouverts ; PAIR répartit cette charge entre les machines. Nous avons décrit l'exécution d'Hermes 100 % en local avec Qwen et Nemotron sur RTX et DGX Spark : PAIR ajoute la répartition sur plusieurs de ces machines. NVIDIA indique à XDA avoir testé jusqu'à 18 GPU dans un même cluster.
La documentation NVIDIA décrit elle-même la limite de la beta. Le scheduler classe les nœuds éligibles d'après le travail en file et un signal de charge grossier : le GPU le plus occupé de la machine, rangé en paliers à 40, 70 et 85 %. Il ignore le modèle de GPU, la mémoire disponible, la latence mesurée, le fait qu'un modèle soit déjà chargé et le coût apparent de la requête. Sur un cluster hétérogène, NVIDIA prévient qu'une requête peut atterrir sur la machine la plus lente ; l'épinglage manuel d'un nœud reste le recours. Sandhya (@agenticgirl) en a publié sur X le résumé le plus précis.
PAIR et NeMo Switchyard s'empilent
NVIDIA a annoncé le 11 août 2026 un autre routeur, NeMo Switchyard, écrit en Rust et encore en pré-1.0. Comme PAIR, Switchyard expose un endpoint unique devant plusieurs cibles.
| PAIR | NeMo Switchyard | |
|---|---|---|
| Question à laquelle il répond | Quelle machine du réseau exécute cette requête ? | Quel modèle ou quel fournisseur répond à ce tour ? |
| Cibles | PC RTX, DGX Spark, Mac, via Ollama ou LM Studio | vLLM, NIM, Ollama, tout endpoint compatible OpenAI (OpenRouter compris) |
| API côté client | Ollama, compatible OpenAI (LM Studio) | OpenAI Chat et Responses, Anthropic Messages |
| Critères de décision | Nœud joignable, moteur compatible, modèle à l'inventaire, file et charge GPU | Coût, qualité, étape du workflow, classifieur LLM, politique (précision, coût, latence) |
| Données | Restent sur le réseau local | Peuvent sortir vers des API externes |
| Usage visé | Cluster domestique ou de laboratoire | Orchestration multi-modèles |
Dans un empilement, l'application appelle Switchyard, qui décide qu'un tour de conversation mérite un modèle local plutôt qu'une API cloud, et transmet à PAIR, qui décide quel PC du réseau prend la requête et la passe à Ollama. Switchyard relève de la famille des LLM routers que nous avons décrite en trois métiers ; PAIR n'y entre pas, puisqu'il ne choisit jamais le modèle.
Sécurité : PIN, mTLS et réseau de confiance
Le code PIN sert au bootstrap de l'appariement ; NVIDIA le dit de faible entropie et déconseille de le traiter comme un identifiant durable. Une fois appariés, les nœuds font passer l'essentiel de leur trafic en mTLS, et les applications locales n'atteignent PAIR qu'en loopback. Une partie de la découverte circule en HTTP clair : nom de machine, inventaire matériel et taux d'utilisation d'un nœud sont lisibles par tout appareil du sous-réseau, un compromis que NVIDIA dit avoir choisi en connaissance de cause. La documentation réserve le logiciel à un réseau de confiance, celui de la maison ou du labo, et le SECURITY.md du dépôt range le réseau partagé d'un bureau parmi les réseaux potentiellement hostiles. Yannya (@Yyaannyyaa) le rappelle sur X : en local, on fait confiance au réseau autant qu'au logiciel.
Ce que ça change pour une équipe d'ingénierie
NVIDIA publie un logiciel gratuit qui rend plus utiles des GPU déjà vendus. Chaque modèle ouvert qui tourne en local justifie une carte RTX ou un DGX Spark de plus, et PAIR rend ce parc exploitable en commun. Le 25 août, Perplexity lançait Portable Computer, la version locale de son agent Perplexity Computer, développée avec NVIDIA et disponible au lancement sur DGX Spark sous Linux. NVIDIA l'a présenté à l'IFA aux côtés de PAIR, sur les cartes RTX dotées d'au moins 24 Go de VRAM.
Pour une équipe qui fait tourner des agents sur des modèles ouverts, les postes RTX des développeurs et leurs Mac M4 forment un pool d'inférence sans licence et sans sortie de données, à condition de les isoler sur un segment réseau dédié plutôt que sur le Wi-Fi du bureau. Pour l'essayer :
- installer PAIR sur chaque machine et les apparier par PIN ;
- activer Ollama ou LM Studio et dupliquer le tag de modèle sur chaque nœud ;
- pointer l'agent (Hermes, OpenClaw ou un script maison) vers 127.0.0.1:11434 ou :1234 ;
- ouvrir la vue Jobs pour vérifier le placement réel, et épingler un nœud si le scheduler choisit mal.
Le gain tient à deux conditions : des requêtes indépendantes en nombre (sous-agents, jobs batch, plusieurs développeurs sur le même modèle), et des modèles qui tiennent individuellement sur chaque machine. Un modèle qui ne tient que sur le DGX Spark sera servi par ce seul nœud, et les postes RTX du réseau ne lui serviront à rien.
La version 0.1.1 place les requêtes d'après la file et une charge GPU grossière. La question ouverte pour 2027 : NVIDIA fera-t-il de ce scheduler un vrai ordonnanceur (VRAM libre, latence, coût), ou cette couche reviendra-t-elle aux frameworks d'agents et aux routeurs de modèles comme Switchyard ?
FAQ
NVIDIA PAIR additionne-t-il la mémoire vidéo de plusieurs machines ? Non. Chaque requête s'exécute entière sur un seul nœud, avec sa propre VRAM. Un modèle trop gros pour la plus grosse machine du réseau reste impossible à servir, avec ou sans PAIR.
Faut-il modifier les applications qui utilisent déjà Ollama ? Non. PAIR prend le port 11434 d'Ollama (et 1234 pour LM Studio) et décale le moteur sur un port supérieur. L'application continue d'appeler 127.0.0.1:11434, qui est désormais le routeur.
PAIR accélère-t-il une conversation avec un seul modèle ? Non. Une génération isolée prend le même temps. Le gain apparaît quand plusieurs requêtes indépendantes arrivent en même temps : sous-agents, traitements par lots, plusieurs utilisateurs.
Quelle différence avec NeMo Switchyard ? Switchyard choisit quel modèle ou quel fournisseur répond, cloud compris. PAIR choisit quelle machine du réseau local exécute un modèle déjà choisi. Les deux peuvent s'empiler.
Peut-on déployer PAIR sur le réseau d'une entreprise ? Pas sur le réseau partagé du bureau, que le SECURITY.md de NVIDIA classe comme potentiellement hostile. Le PIN d'appariement est de faible entropie et l'inventaire des nœuds est lisible depuis le sous-réseau : un essai se fait sur un segment réseau dédié.
Sources
Officiel NVIDIA
- Seth Schneider, « NVIDIA PAIR Virtual Inference Router Expands Available Compute on Your Local Network », NVIDIA Technical Blog, 3 septembre 2026. Démo Hermes Desktop et Qwen 3.6 35B A3B (moyennes, démonstration non officielle) — developer.nvidia.com.
- Gerardo Delgado, « Sparks Fly: NVIDIA Accelerates Local AI at IFA 2026 », NVIDIA Blog, 3 septembre 2026. Présentation de PAIR et de Perplexity Portable Computer sur RTX — blogs.nvidia.com.
- Page produit « Personal AI Router for Local Inference ». Matériel validé, RAM et disque — nvidia.com.
- Documentation PAIR, vue d'ensemble. Ce que PAIR ne fait pas — docs.nvidia.com.
- Documentation PAIR, « Getting Started ». Ports, fonctionnement hors ligne, machine sans GPU — docs.nvidia.com.
- Documentation PAIR, « Architecture ». Découverte, mTLS, éligibilité, scheduler, épinglage — docs.nvidia.com.
- Documentation PAIR, « Known Issues ». Limites du scheduler, service qui ne répond plus — docs.nvidia.com.
- Playbook « Install and Use NVIDIA PAIR », mis à jour le 17 août 2026. Support RTX PRO (Turing et plus) — build.nvidia.com.
- Dépôt NVIDIA/Personal-AI-Router (Apache 2.0, OS supportés, releases v0.1.0 du 26 août et v0.1.1 du 28 août 2026) — github.com.
- SECURITY.md du dépôt Personal-AI-Router. PIN de faible entropie, trafic en clair, réseau de bureau partagé — github.com.
- « NVIDIA RTX Spark », page produit — nvidia.com.
- « Route AI Agent Workloads Across Models with NVIDIA NeMo Switchyard », NVIDIA Technical Blog, 11 août 2026 — developer.nvidia.com.
- NeMo Switchyard, dépôt (Rust, pré-1.0) — github.com.
- nemo-switchyard sur PyPI : v0.1.0 du 30 juin 2026, v0.2.0 du 10 août 2026 — pypi.org.
Presse
- Adam Conway, « I connected two PCs to one AI endpoint with Nvidia's new router, and got it serving an engine it doesn't support », XDA Developers, 3 septembre 2026 — xda-developers.com.
- Alfonso Maruccia, « Nvidia's PAIR software turns idle home computers into a local AI cluster », TechSpot, 4 septembre 2026. Chiffre de 165 téraFLOPS et citation de Seth Schneider — techspot.com.
- Asif Razzaq, « NVIDIA Releases Personal AI Router (PAIR) », MarkTechPost, 4 septembre 2026 — marktechpost.com.
- Lori Grunin, « Nvidia PAIR speeds AI agents by annexing PCs on your network », CNET, septembre 2026 — cnet.com.
- Allison Johnson, « Nvidia launches free tool that links idle computers into a personal AI data center », The Verge, septembre 2026 — theverge.com.
- 西川和久, essai terrain, PC Watch, 8 septembre 2026 — pc.watch.impress.co.jp.
- Sergio De Simone, « NVIDIA Personal AI Router Distributes AI Tasks across Local Compute », InfoQ, 11 septembre 2026 — infoq.com.
- Maria Deutscher, « Perplexity AI launches Portable Computer on-device AI agent », SiliconANGLE, 25 août 2026 — siliconangle.com.
Posts sur X
Articles similaires
Souveraineté : exécution 100 % locale d'Hermès avec des modèles open weight (Qwen, Nemotron) sur NVIDIA RTX / DGX Spark
Pour une DSI soumise à des exigences de souveraineté ou de confidentialité, Hermès Agent peut fonctionner sans aucun appel cloud : agent model-agnostic, modèles open weight (Qwen 3.6, NVIDIA Nemotron), inférence locale via vLLM, Ollama ou LM Studio sur NVIDIA RTX ou DGX Spark.
LLM routers : trois métiers sous un même nom
Marketplace, plan de contrôle, optimiseur d'agents : le marché des AI gateways vend trois produits différents sous une étiquette unique. Les confondre mène à de mauvais achats. La grille de lecture, les stratégies de routage, et ce que le rachat d'OpenRouter par Stripe change à l'architecture.
Un modèle par tâche : le guide du routing multi-modèles
Faire tourner toute une usine logicielle sur un seul modèle frontier, c'est payer le tarif du raisonnement pour lire des logs. La mécanique du routage multi-modèles : un modèle par phase, une passerelle unique, l'isolation des sous-agents et la règle qui dit quand le multi-agents mérite son coût.
ZML/LLMD : et si le « Docker des LLM » était français ?
Le 8 juillet 2026, la startup parisienne ZML publie LLMD, un serveur d'inférence qui fait tourner les LLM sur cinq familles de puces (NVIDIA, AMD, Google, Intel, Apple) depuis une seule base de code. Décryptage technique et lecture souveraineté du « Docker des LLM ».